我和孩子有一个睡前游戏:轮流说一颗不存在的星球,越奇怪越好。蘑菇星球、彩虹星球、长着大象鼻子的星球、隐形星球——规则只有一条,不能是地球上有的东西。
问题是,说完就没了。第二天再问,只剩下”昨天那个特别奇怪的”这种模糊印象。想象力被说出口,然后散在空气里。
所以这段时间,我把它做成了一个能住进去的东西:奇怪星球(Wonder Planet)——一个给 4–9 岁孩子和家长的、语音优先的 3D 星球回忆库。孩子按住麦克风描述一颗星球,AI 让它显影,飞船带他登陆,他讲的故事会变成一本会朗读的绘本,最后收进舰长日志。
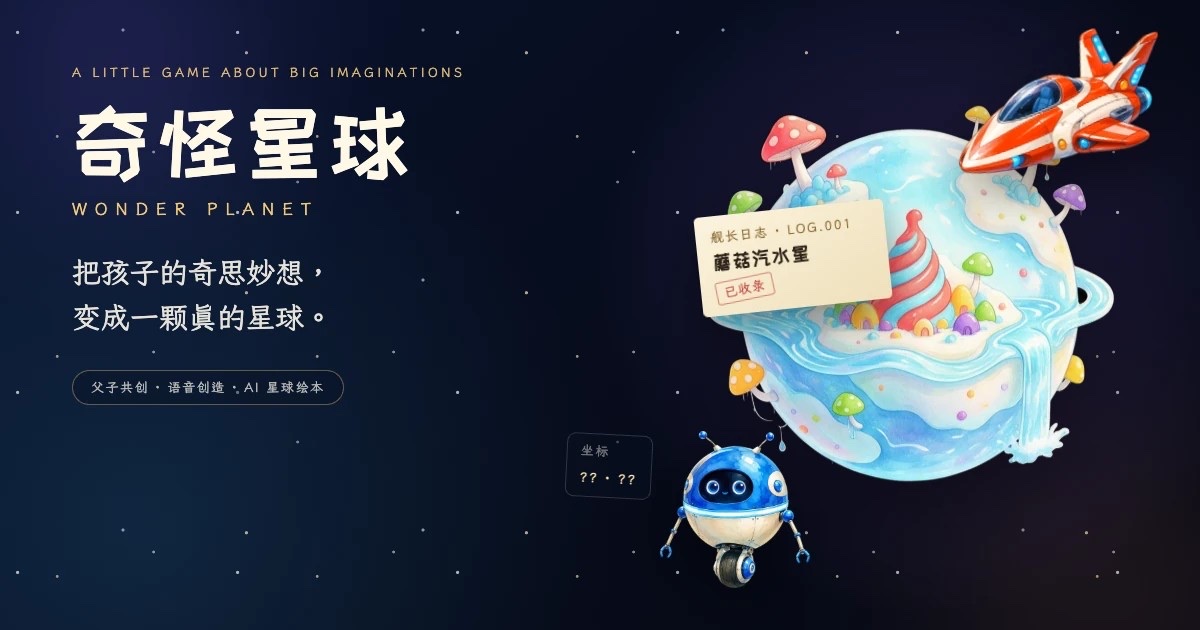
它是什么
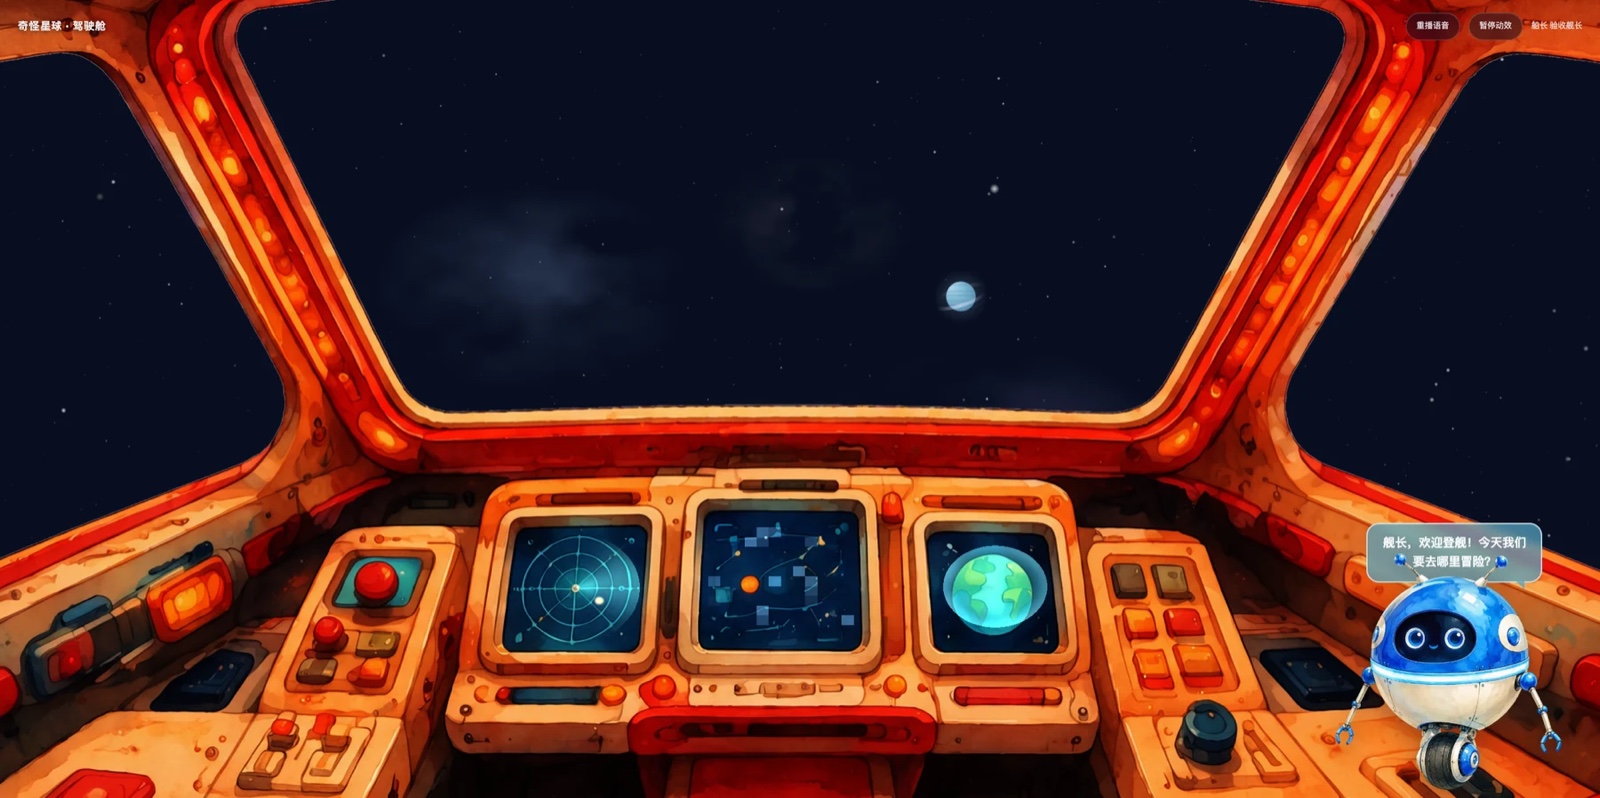
打开应用,你在一艘飞船的驾驶舱里。舷窗外是缓慢漂移的星空,右下角蹲着机器人伙伴「滚滚」,控制台上有三块屏幕。没有注册表单,没有输入框,没有”下一步”。
所有的创造都走同一条五幕远征:
- 发现——跃迁到一片未知星域,雾里有一颗看不清的星球。
- 扫描——孩子按住麦克风描述它:什么形状、什么颜色、上面住着谁。扫描终端会一行行打印出分析日志,星球在舷窗里从线框慢慢显影成水彩。
- 登陆——孩子确认成像后,飞船降落,星球上摊开一本手账。
- 探险记录——滚滚按”发生了什么 → 后来怎样 → 怎么解决”三段式引导孩子讲故事。这一步不能跳过。
- 命名与收录——发现者给星球取名,绶带展开,盖上”已收录”的章,星球进入舰长日志。
对孩子来说,这里没有一个步骤叫”填写内容”。他要做的只是说话,以及决定要不要重新扫描。产品约束也很硬:只做桌面端,视口 ≥1024px。四到九岁的手和一块驾驶舱,塞不进手机竖屏;与其做一个将就的移动版,不如把桌面体验做完整。
从一句话到一颗星球
星球生成是整件事里最贵、最慢、也最容易做错的一环。
最初的方案是程序化生成:定义一个形状枚举——球形、蘑菇形、彩虹拱、象鼻、隐形、组合——每种形状写一个 builder,用 Three.js 拼出来。探针阶段它跑得很好,蘑菇星球的伞盖、菌褶、菌柄、发光的小屋都成立,秒级渲染,零边际成本。
但这个方案有一个致命问题:枚举本身就是想象力的硬闸门。孩子说”一颗长着大象鼻子的星球”,代码里没有这个形状,要么回退成球,要么我得再写一个 builder。每一种新想象都要一次开发,这不是产品,是许愿池。
所以正式版推翻了它,换成”先看见,再变成 3D”:
- 口述先由 LLM 解析成结构化的星球 DNA:形状、配色、地貌、居民、特殊属性,Zod schema 带版本号,所以渲染器以后可以升级而不破坏老数据。
- DNA 交给生图模型(火山引擎 Seedream),生成一张干净背景的星球插画。
- 孩子确认或重新生成。这一步是确认门:不满意就重画,图片便宜,可以反复。
- 确认之后,图片才进入图转 3D。在线走 Tripo3D,把正面、背面、左侧、右侧四张视图一起送进去做 multiview-to-model;本地备选是 ComfyUI 跑 TRELLIS 2 / TripoSR。
- 产出的 GLB 交给 Three.js 加载,孩子可以拖着转、滚轮放大。
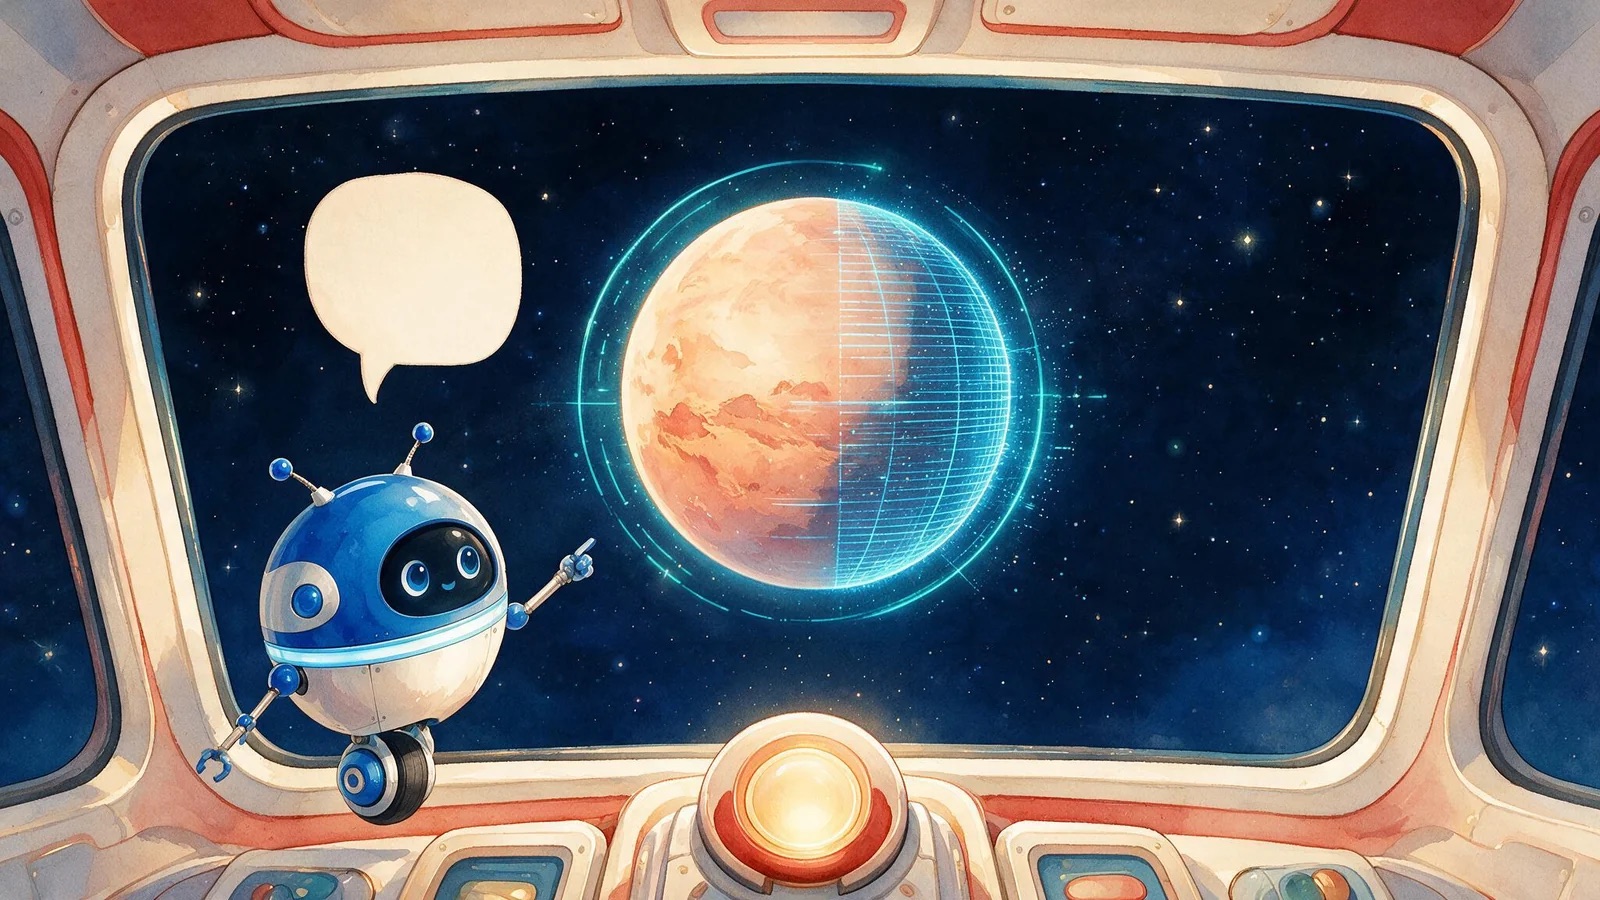
这里有一个体验上的关键决定:3D 生成全程在后台异步跑。图转 3D 要花几分钟,但它不阻塞登陆、讲故事和命名。等日志收录的时候,如果模型已经就绪,孩子会看到一颗能转的 3D 星球;没就绪就显示”锻造炉还在工作中”,下次回访再揭晓。图转 3D 彻底失败也不会白屏——回退到程序化球体,保留配色和地貌。旧方案没有死,它降级成了兜底。
故事才是产品
星球只是舞台。真正想让孩子练习的,是”把一件事讲清楚”。
所以远征里的探险记录没有跳过按钮。滚滚会依次问:发生了什么?后来怎样了?怎么解决的?每段讲完,它复述一遍要点再继续;如果某段太短,它会基于已讲的内容做一次情境追问。要是孩子实在讲不下去,已有问答会被拼成一个最小故事,确认后照样进入下一步——可以简单,但不能断。
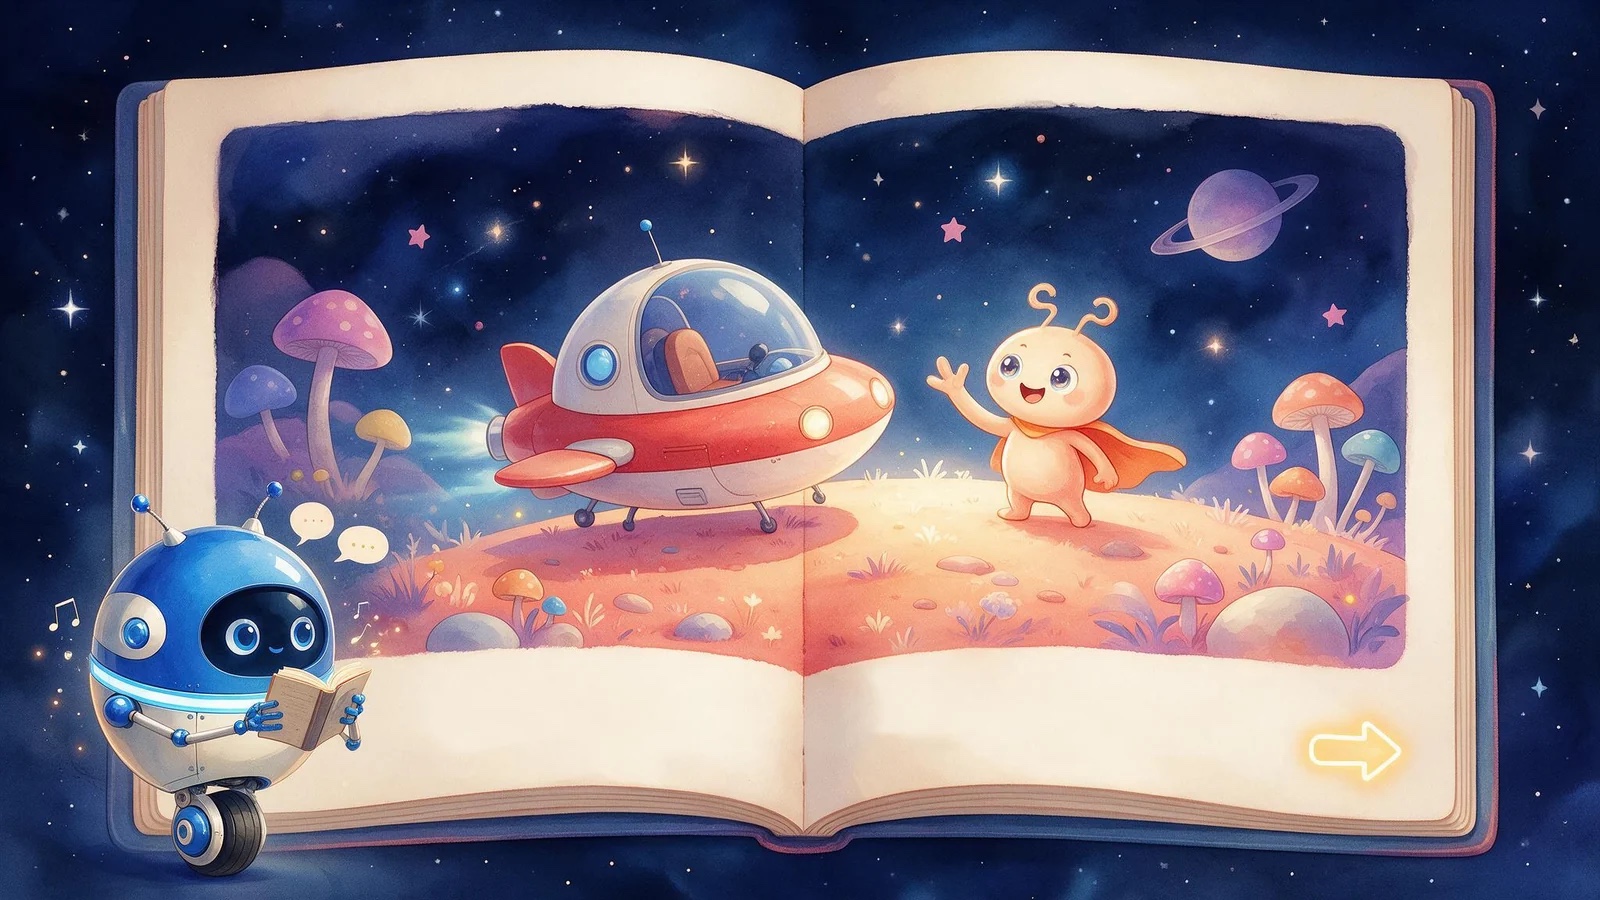
故事确认的瞬间,后台漫画链就启动了:LLM 润色 → 拆成 4–8 格分镜 → 逐格并发生图。每一格都带上一张”当前飞船”的参考图,保证漫画里的飞船和驾驶舱里的是同一艘;星球和飞船的 ID 会作为快照写进故事——以后换了飞船,老故事里的飞船还是当年那一艘。
漫画出来后,每一格配一句旁白,由服务端 TTS 逐格朗读,当前朗读的格子高亮。手账里的汉字上方可以打开拼音,孩子能自己读;家长也可以直接在同一个 contenteditable 里改错字,改字不会打断讲故事。
这套东西听起来像”儿童版 AI 工具”,但真正花时间的不是模型,是节奏:什么时候该等,什么时候不该等;什么时候让孩子看见进度,什么时候该用一场命名仪式把等待藏起来。
那些坏掉的东西(以及它们改掉的设计)
浏览器语音合成,会静默吞字。 最早朗读用的是浏览器 speechSynthesis。本机实测:调用 speak() 之后没有 onstart、没有 onerror、没有 onend,speaking 和 pending 永远是 false,cancel() 和手势补播全部无效。同一套浏览器音频子系统里的 <audio> 也观察到整条管线卡死。这不是应用层能修的 bug,是引擎不可靠。于是我把 speechSynthesis 通路从代码里整体删掉,朗读改成唯一一条服务端 Edge TTS:前端只负责 <audio> 播放。固定台词(滚滚的常用语)预生成成 MP3,动态台词才实时合成,音色只有一个事实源 voice.config.json。
语音识别,不能指望浏览器。 Chrome 的 Web Speech 在后面接的是 Google 在线服务,国内网络下实测不可用。所以主力换成服务端离线 sherpa-onnx(zipformer 中文模型,598MB,模型不进仓库,CPU 即可跑),浏览器识别降为兜底,家长打字是最后一层。儿童语音本来就难认,识别结果永远可编辑——这条不是容错,是产品的一部分。
渲染 bug,测试看不出来,截图能。 正式开发前我先写了一个单文件探针,验证 3D 星球和 AI 漫画两条管线。探针版本里,蘑菇星球的所有表面装饰——小屋、蘑菇小人、草丛——整体埋进了伞盖内部。写代码的时候完全没发现,是无头浏览器截图一眼看出来的:Y 坐标公式算错了。从那天起,”渲染必须有视觉自测”变成了这个项目的硬规矩。
等待,要藏进剧情里。 图转 3D 要几分钟,漫画也要几分钟。进度条是最差的选择。命名仪式、绶带展开、盖章收录,这些仪式本身就是天然的等待缓冲;渐进阅读也一样——“下一页”只在下一格图就绪后才出现,孩子看到的是故事在长出来,而不是加载中。
代码长什么样
项目是一个 pnpm monorepo:
apps/web:React 18 + Vite + Tailwind + react-three-fiber,五幕远征是一个单路由场景状态机。apps/api:Hono on Node + Drizzle + better-sqlite3;生图、图转 3D、TTS、ASR 全部在服务端,key 只存在于本地.dev.vars。packages/dna:星球 DNA 与分镜脚本的共享 Zod 契约,带 schema 版本。packages/renderer:Three.js 渲染与画质分级,含无头截图自测。
架构上刻意保持”本地优先、可平移”:数据库是本地 SQLite,图片存本地磁盘,身份是单机舰长档案,但所有业务数据都带 user_id,并走身份适配层——以后接 better-auth 多账号时不用推倒重来。目标形态写死在技术方案里:Pages Functions + D1 + R2,同一份 Hono 应用、同一套 migration、同一套 schema,换的只是适配层实现。
目前整个仓库约 2.4 万行 TypeScript/TSX,260 多个 vitest 用例,类型检查和生产构建都通过。桌面端的三条前瞻纪律(Pointer Events、流式布局、画质分级)也从第一行代码就守着,将来要做平板横屏,是 UI 重排,不是重写。
现在在哪
游戏本体目前还是本地运行版本,还在持续迭代;但它的作品介绍页已经上线,两段真实游玩实录也录好了:
- 项目介绍与游玩实录:wonderplanet.app
- 发现新的星球(2:50):跃迁、扫描、显影,然后登陆
- 舰长日志与故事朗读(2:30):造访心情、故事朗读、回看创造的星球
下一步是把它真正搬到线上:多账号 + better-auth + Cloudflare 部署,然后是互访其他舰长的公开星球、舰长形象的三视图参考(让漫画里出现孩子自己)、以及旧星球手动升级 3D 模型。
这个项目最让我意外的部分,不是哪个模型效果更好,而是”把想象留下来”这件事本身有多具体:一颗星球、一本会读的绘本、一个随时能回去的日志。孩子长大后未必记得某天晚上说过什么,但日志里那颗星球还在。
项目地址:https://wonderplanet.app/。如果你也在做类似的东西,或者想和孩子一起造一颗星球,欢迎来信。