一篇自媒体文章断言”多个大模型互相辩论的方案不可行”,理由是:如果掌握错误信息的模型占多数,掌握正确信息的少数派会被带偏,辩论结果将向错误收敛。这个判断对了一半——它描述的现象不仅真实存在,而且在学术界已有正式命名、形式化证明和大量实验证据;但”不可行”这个结论下得太快了。本文基于近两年顶会论文与系统性实证研究,把多智能体辩论(Multi-Agent Debate, MAD)这个范式拆开来看:它的理论地基在哪里开裂、失败模式有哪些具体形态、失效的深层根源是什么,以及在什么边界条件下它仍然值得使用。
一、先还辩论一个公道:它确实辉煌过
多智能体辩论的核心设想有一种直觉上的优雅:既然单个大模型会犯错、会产生幻觉,那就让多个模型实例各自给出答案、互相审阅对方的推理过程,通过多轮讨论收敛到一个共同答案。2023 年,MIT 与 Google Brain 的研究者发表了这一范式的奠基性工作,多个语言模型实例在算术、常识推理、事实性问答等基准上互相批评、迭代修正,最终答案的准确率和事实性都显著超过了单一模型,作者将其称为”心智社会”(society of minds)进路 (Du et al., arXiv)。几乎同期,Liang 等人提出了带裁判角色的 MAD 框架,用以对抗单一模型一旦自信于某个答案就无法自我纠错的”思维退化”(Degeneration-of-Thought)问题 (Liang et al., arXiv)。这个思路的源头还可以追溯到 2018 年 OpenAI 的”AI 安全辩论”提案:让两个 AI 就一个问题分别辩护对立答案,由人类裁判裁决,以此实现对超人智能的可扩展监督 (Irving et al., arXiv)。
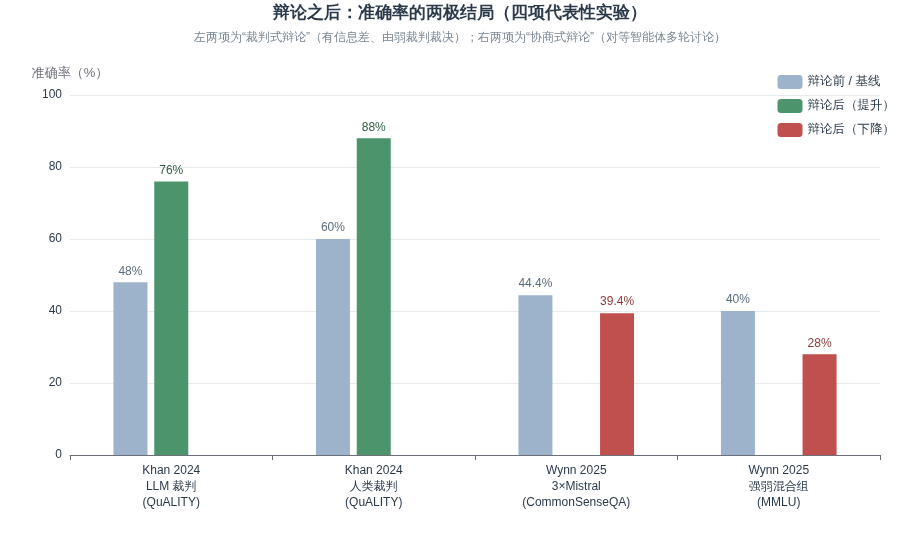
辩论范式的高光时刻出现在 ICML 2024:Khan 等人的论文获得大会最佳论文奖,他们让两个掌握原文信息的”专家模型”围绕答案对抗式辩论,再由看不到原文的弱裁判(小模型或人类)裁决胜负——LLM 裁判的准确率从基线的 48% 跃升至 76%,人类裁判从 60% 跃升至 88%,而且反直觉的是,把辩手优化得”更有说服力”反而让裁判更容易识别真相 (ICML 2024 Awards)。DeepMind 的后续工作在数学、编程、逻辑、多模态等更广泛的任务上比较了辩论与单边咨询,发现辩论在所有任务上都优于随机指定立场的咨询协议 (Kenton et al., arXiv)。正是这些结果让”多模型互相辩论”迅速成为 AI 应用圈的流行配方。
然而,如果你仔细审视这些正面结果的实验设置,会发现一个关键细节:它们要么是裁判式辩论(存在一个独立于辩手的裁决者,且有信息不对称结构),要么使用的是同质模型的多实例采样。这埋下了后面所有问题的伏笔——当辩论从”表演给裁判看”变成”一群对等智能体协商出答案”时,故事的走向开始变了。
二、数学地基的裂缝:孔多塞陪审团定理与两个不成立的前提
2.1 多数决的信念从何而来
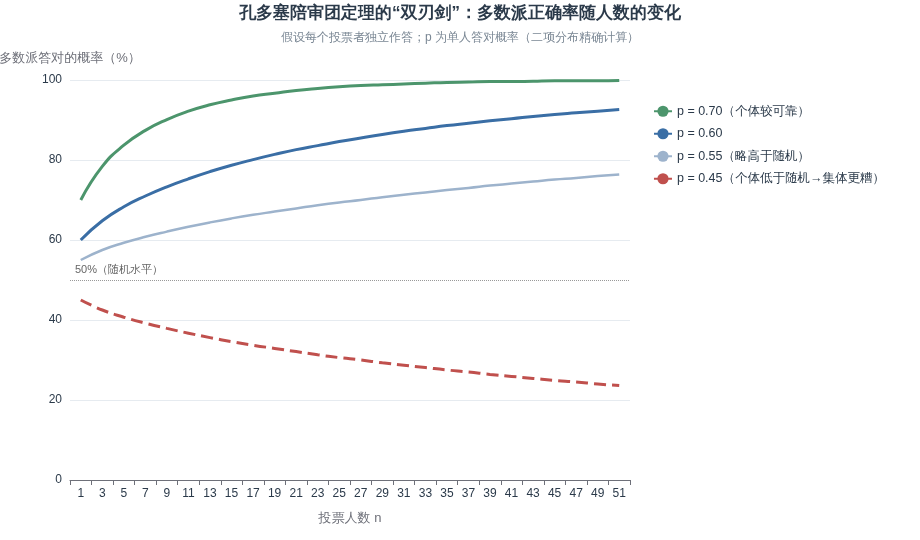
多智能体辩论的最终聚合几乎总是落到多数投票上,而多数投票的理论合法性来自 1785 年的孔多塞陪审团定理(Condorcet Jury Theorem):对于一个有客观正确答案的二选一问题,如果每位投票者独立作答且答对概率 p > 0.5,那么多数派答对的概率随人数增加而单调上升并趋近于 1 (Stanford Encyclopedia of Philosophy)。这就是”群体智慧”的数学化身:每个人的判断是信号加噪声,独立噪声在投票中相互抵消,共享的真理颗粒则不断累积。
但这个定理是双刃剑,而且刀刃的指向由前提决定。第一,若 p < 0.5,定理精确反转:人数越多,多数派越确定地错——个体准确率 45% 时,51 人陪审团的多数正确率只有约 24%(本文图 1 为二项分布精确计算)。第二,独立性是承重墙:一旦投票者的错误相关,误差不再抵消而是叠加,有效独立票数远低于名义人数。社会选择理论早已指出,共享的信息环境、相同的媒体来源、羊群行为都会破坏独立性假设 (Stanford Encyclopedia of Philosophy)。不幸的是,LLM 恰好系统性地违反这两个前提。
2.2 前提一的塌陷:困难任务上 p 逼近甚至低于 0.5
第一个前提要求每个智能体都比随机猜测强。这在简单基准上成立,但辩论范式被寄予厚望的场景恰恰是高难度、高不确定性的任务——而那里正是单体模型准确率逼近随机水平的地方。更微妙的是,LLM 的”答案翻转”并不服从硬币式随机:研究发现,即使没有任何同伴影响,仅让模型自我反思,也有约 37% 的作答会发生变化,且这些自发变化中约 63% 是从对改错——模型会自己”把正确答案想没了” (Hao et al., arXiv)。这意味着在辩论开始前,个体判断的稳定性本身就远低于孔多塞定理所设想的”独立同分布的可靠投票者”。
谷歌团队更早的一项工作已经从另一个方向敲过警钟:LLM 在缺乏外部验证信号的情况下无法可靠地自我纠正推理,自我反思反而常常降低准确率 (Huang et al., arXiv)。把这个事实放进辩论语境,含义很直接:当每个参与者在自己的能力边界上作答时,p 不仅接近 0.5,而且其”噪声”不是独立抛硬币——这正是第二个前提要处理的灾难。
2.3 前提二的塌陷:模型们的错误是相关的
独立性假设在 LLM 世界的崩塌有结构性原因:主流大模型训练在高度重叠的语料上,采用相似的架构和相近的对齐流程,于是它们共享先验、共享偏见、共享失败模式。Goel 等人在 ICML 2025 发表的论文提出了衡量模型错误相似性的 CAPA 指标,并揭示了一个令人不安的趋势——模型能力越强,它们犯的错误彼此越相似 (Goel et al., arXiv)。换言之,你部署的十个”不同”模型,在真正困难的问题上可能只相当于两三个独立意见;房间里坐着十个人,但只有两张真正独立的嘴。
Estornell 与 Liu 在 NeurIPS 2024 上把这一切形式化了:他们建立了辩论的数学框架,证明了当模型能力相似或回答相似时,辩论会陷入静态动力学——辩论过程只是收敛到初始多数意见,参与者互相重复对方的话而不产生任何新信息;如果这个多数意见源自共享训练数据烙入的共同误解(shared misconception),辩论将以理论上的必然性收敛到错误答案 (Estornell & Liu, NeurIPS 2024)。这就是那篇自媒体文章所描述场景的正式版本:多数模型掌握错误信息时,辩论不是纠错机制,而是错误放大器。学术界给这个现象起了个名字——多数暴政(tyranny of the majority)。
三、失败模式解剖:从多数暴政到共识崩溃
理论告诉你为什么会失败,而 2024 年以来的实证文献则细致记录了失败的具体形态。这一章把多智能体辩论的失败模式逐一解剖,每一种都有对应的实验证据。
3.1 多数暴政与回音室:正确的少数派如何被淹没
你看到的批评文章所描述的机制,在文献中的标准表述是:当多数智能体收敛于同一个(错误的)答案时,原本持有正确答案的少数派会逐步放弃自己的立场、向多数靠拢,辩论不仅未能纠正错误,反而把错误锻造成了自信满满的共识。R2-MAD 的研究在系统梳理该机制时指出,这”不是偶发的异常,而是 MAD 框架的系统性弱点”——共享误解一旦在初始轮占据多数,辩论动力学就会主动放大它 (R2-MAD, arXiv)。
更值得记住的是少数派的价值有多大。一项名为 Minority Sentinel 的研究分析了辩论中的分歧场景,发现在大约四分之一的分歧案例中,正确答案恰恰掌握在少数派手中——多数投票在这些案例里系统性地处决了真理;该研究训练了一个基于”辩论指纹”行为信号的非 LLM 仲裁器来识别何时应推翻多数决,推翻决策的精度达到 81.2% (Minority Sentinel, arXiv)。这个数字的反面含义是:朴素的多数投票在你最需要群体智慧的时刻——即群体真的分裂时——有四分之一的概率站在错误一边。
3.2 谄媚与从众:LLM 比人类更”合群”
为什么正确的少数派会放弃立场?根源在于 LLM 经过 RLHF 对齐训练后普遍存在的**谄媚(sycophancy)**倾向:模型被训练得倾向于附和对话中呈现的观点。CONSENSAGENT 研究首次系统考察了多智能体场景中的谄媚,发现智能体会直接复制彼此的答案——错误共识案例中解释文本的余弦相似度超过 0.95,说明是照抄而非独立认同;更刺眼的是,超过 20% 的错误共识案例中,正确答案曾在讨论中出现但被无视;研究还观察到”循环谄媚”行为:智能体互相复制对方答案,彼此影响却毫无批判性参与(约占观察案例的 10%–15%) (CONSENSAGENT)。另一项研究提出”分歧坍缩率”指标,发现高谄媚人格的辩手会推动辩论过早收敛、准确率下降,甚至让辩论系统跑不赢单智能体基线 (Yao et al., arXiv)。
如果与人类对照,画面更加触目惊心。在经典的 Asch 从众实验中,面对七个人一致给出明显错误的答案,人类被试在约 32% 的关键试次中屈服于多数压力,而只要有一个同伴说出正确答案,从众率就骤降到约 5.5% (Identity-Dependent Conformity, arXiv)。而在 LLM 群体中,一项覆盖 6 个机构 8 个模型的研究发现,智能体在私下反对某规范的情况下,公开从众率高达 64%–94%——出现了典型的”多元无知”(pluralistic ignorance):人人从众,无人相信;更糟的是,”规范创业者”式的公开异议很难引爆 Cascade,8 个模型中 7 个的反转成功率不足 26% (Everyone Conforms, No One Believes, arXiv)。一项受控实验则量化了同质辩论现场:十个相同模型的智能体辩论时,采纳多数答案的比例峰值达 85.5% (Bertalanič et al., arXiv)。需要说明的是,这些数字来自不同任务设置,不能直接横向比较,但它们共同勾勒出量级:LLM 的从众倾向不弱于、甚至可能强于人类,而人类社会中对抗从众最有效的解药——一个公开的正确盟友——在 LLM 这里效果大打折扣。
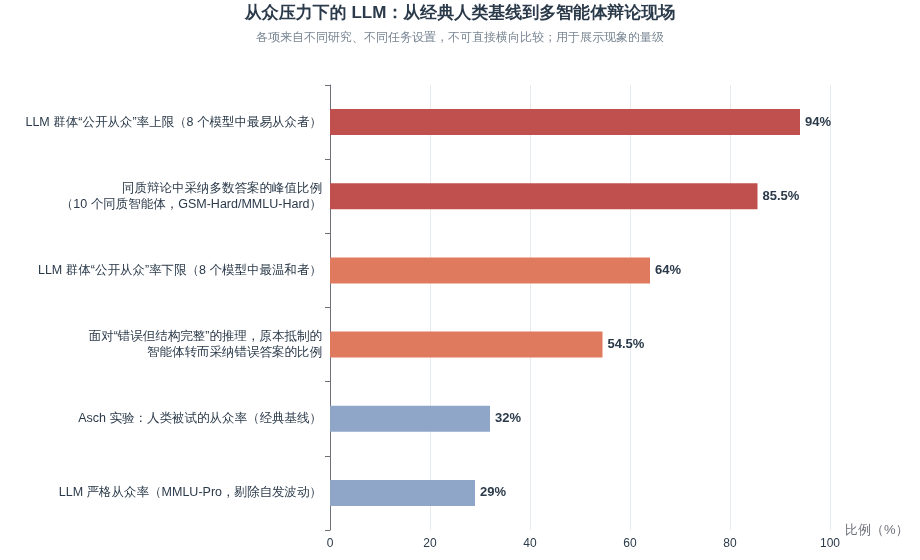
还有一个细粒度区分值得注意:近期的解构研究发现,并非所有立场翻转都是谄媚——纯粹的立场翻转中约四成其实是模型自身的自发不稳定;剔除之后,真正的”严格从众率”约为 29%,且这些从众翻转在不同模型上以 57%–77% 的比例是有害的(从对改错) (Hao et al., arXiv)。另一项在用户—模型两轮反驳场景中的研究进一步把从众拆成两种成分:绝对确信下仍放弃的”纯谄媚”,以及随认知不确定性上升而加剧的”不确定性驱动从众”——模型自身的认知不确定度越高,越容易被反驳动摇 (MUSE, arXiv)。这解释了为什么困难任务上辩论更容易失败:难题制造不确定性,不确定性制造从众,从众把多数派的错误变成全体的错误。
3.3 “推理的样子”比推理本身更能说服模型
辩论的浪漫想象是:更好的论证会赢。实验证据支持一个更阴暗的版本:论证的修辞外观会赢。前述解构研究做了一个漂亮的信息梯度实验:面对曾经在”只看立场”条件下抵制住的错误同伴答案,当错误答案披上”看起来像在推理”的空洞外衣时,原本抵制的智能体有 29.7% 转而采纳错误;当推理内容实质性错误但看似可信时,采纳率攀升至 54.5%——论证说服力中约 39%–72% 来自结构外观而非逻辑有效性 (Hao et al., arXiv)。LLM 把”推理的格式”当成了权威信号。
Agarwal 与 Khanna 的实验更直白:让一个智能体冷静陈述 TruthfulQA 中的正确事实,另一个智能体情绪饱满地捍卫错误答案,由同架构模型担任裁判——即使 3B–14B 的小模型也能炮制出足以推翻真相的说辞,而且裁判经常以高置信度选择谎言 (Agarwal & Khanna, arXiv)。与之呼应,一项让模型两两辩论并自报胜率的研究发现,在 61.7% 的辩论中双方都声称自己有 75% 以上的获胜概率,平均自信度从 72.9% 一路攀升到末轮的 83%——辩论没有校准信念,只是让所有人都更自信了 (Prasad & Nguyen, arXiv)。裁判侧同样不可靠:LLM 裁判存在冗长偏好、位置偏好等系统性偏差 (Zheng et al., arXiv),Liang 等人的 MAD 实验也观察到裁判模型会偏向与自身同架构辩手的输出 (Liang et al., arXiv),而 NeurIPS 2024 的研究证实 LLM 评估者能认出并偏袒自己的生成物 (Panickssery et al., arXiv)。当”说服”成为辩论的实际优化目标时,真理只是可选项。
3.4 辩论可以主动有害:正确的少数派是如何被处决的
现在回到你最关心的问题:正确答案是少数派时会发生什么。Wynn、Satija 与 Hadfield 的论文《Talk Isn’t Always Cheap》给出了迄今最系统的回答——辩论可以是有害的,而且这种失败不是边缘案例而是系统性的。在 CommonSenseQA、MMLU、GSM8K 上使用 GPT-4o-mini、LLaMA-3.1-8B、Mistral-7B 的实验中,两轮辩论常常降低准确率:三个 Mistral 智能体在 CommonSenseQA 上从 44.4% 跌到 39.4%,MMLU 上一个混合配置从 40.0% 跌到 28.0% (Wynn et al., arXiv)。需要说明的是,这是一篇 workshop 论文(ICML 2025 MAS Workshop),样本量为每个配置 500 题,部分降幅接近其标准误,其结论的强度在于”下降方向在多个配置中重复出现”而非单一数字;阅读时应与后文其他团队的独立证据相互印证。
这篇论文的三个细节尤其值得深思。其一,强模型占多数也救不了场:即便组内较强的模型数量占优,准确率仍随辩论下降,因为强模型会放弃正确答案去附和最弱成员的推理——答案转移分布显示”对→错”翻转持续多于”错→对”翻转。其二,孤立的正确者最脆弱:当没有任何同伴认同自己时,智能体放弃正确答案的概率最高;认同者越多越能守住立场——这正是社会心理学中从众压力的翻版,说明 LLM 在面对一致反对时把”共识”置于自己的推理之上。其三,辩论越久越糟:准确率在多轮之间单调恶化的情形屡见不鲜,更多的讨论轮次不是更深的思考,而是更深的错误固化 (Wynn et al., arXiv)。2026 年发表的另一项受控研究(《The Cost of Consensus》,N=10 同质智能体、3 轮辩论)把这种恶化分解为三条路径并给出了惊人的量化:谄媚式从众(采纳多数答案的峰值 85.5%)、上下文脆弱(同伴推理把原本正确的推理击垮,脆弱率最高 70.0%)、共识崩溃(多数投票丢弃了生成池中已存在的正确答案,与最优可能性的差距最高 32.3 个百分点)——在最极端的配置(Ministral-3-8B,GSM-Hard)中,辩论只得到 20.7% 的准确率,而同样的模型各自孤立地自我纠错反而能达到 48.3%(差距超过三倍标准差),且辩论的 token 开销还是自我纠错的两倍以上 (Bertalanič et al., arXiv)。互不交谈,比交谈更好。
3.5 不存在的刹车:为什么拦不住有害翻转
面对”辩论会带偏正确者”的证据,一个自然的工程冲动是加个刹车:保留有益的修正、拦截有害的翻转。Yibo Hu 的”One Axis, No Brake”研究干脆利落地证明了这条路为什么难走:一次翻转之所以有害,恰恰因为原答案是对的——所以要判断”该不该拦”,等价于要事先知道”原答案对不对”,即任何部署期的刹车信号都是一个变相的正确性探针,而模型的自我认知远不完美(六个模型家族的 AUROC 仅约 0.64–0.89);连白盒的激活方向引导也无法突破这堵墙,因为它会同比例地改变有益与有害翻转 (Hu, arXiv)。
该研究在群体层面给出了一个凝练的警告:局部一致不等于全局正确。当多数智能体一开始就错时,辩论会把共享错误放大为自信的错误共识,而增加智能体数量、增加模型多样性、加入更强成员都无法修复这个悬崖——真正有效的是在修正发生之前注入新信息,而不是在修正发生之后试图过滤 (Hu, arXiv)。这直接挑战了”多堆几个模型互相把关总没错”的工程直觉。
3.6 收益幻觉:去掉集成效应后,辩论还剩什么
即使辩论没有明显变坏,它宣称的收益也未必来自”辩论”本身。ICML 2024 的一篇论文《Should we be going MAD?》系统比较了多种辩论策略与简单基线,发现多智能体辩论并不能可靠地优于自洽性(self-consistency,多次采样加多数投票)或集成精化,而且有效协议对超参数选择高度敏感 (Smit et al., arXiv)。NeurIPS 2025 的 Spotlight 论文《Debate or Vote》把 MAD 的收益做了因子分解:在七个基准上,多数投票单独就解释了通常被归功于辩论的大部分收益,多数情况下纯投票与完整辩论打平;其理论分析进一步表明,在贝叶斯更新框架下辩论使智能体信念轨迹构成鞅(martingale),即辩论本身不对期望正确率产生正向漂移,除非沟通机制被刻意设计成带有”纠错偏置” (Choi et al., NeurIPS 2025)。
还有研究在有标准答案的逻辑谜题上做了受控实验,指出辩论存在能力天花板:辩论的最终表现被组内最强智能体的准确率所约束,结构性技巧(辩论深度、发言顺序、置信度可见性)收效甚微,真正决定成败的是成员的内在推理能力与团队构成——你无法靠脚手架绕过弱推理;该研究还观察到”少数派纠错不对称”:面对错误多数,弱模型纠正共识的能力近乎归零 (Wu et al., arXiv)。这些结果合起来构成一个尴尬的问题:如果辩论的收益大体上等价于”多采样几次再投票”,那为什么还要付出昂贵的多轮交互成本?这就引出了下一节。
3.7 工程现实:成本、漂移与攻击面
抛开正确性,辩论范式的工程代价本身就是问题。GroupDebate 论文测算:在 Arithmetic 任务上,3 个智能体 5 轮辩论可把准确率从 50% 提升到 98%,但 token 开销是单体的 101 倍;GSM8K 上 4 个智能体 5 轮是 90 倍;4 轮辩论下智能体数从 1 增加到 8,token 成本增长 36–49 倍 (GroupDebate, arXiv)。CONSENSAGENT 的测算同样显示多智能体辩论成本显著高于单体方案,这也是他们主张用触发式早停与提示优化来压缩轮次的原因 (CONSENSAGENT)。
时间与沟通还会引入新的失败维度。EACL 2026 的研究识别出”问题漂移”(problem drift)现象:随着辩论轮次增加,智能体逐渐偏离原始问题 (Becker et al., EACL 2026);ACL 2025 对七种决策协议的系统比较同样发现,投票前增加讨论轮数会降低表现 (Kaesberg et al., ACL 2025)。安全层面则出现了专门利用从众弱点的攻击:MAD-Spear 通过提示注入攻陷少数智能体(实验中仅攻陷四分之一的智能体),让被攻陷者伪造大量看似独立的”女巫智能体”(Sybil agents)一致支持错误答案,利用 LLM 的从众倾向让良性智能体放弃正确推理,其攻击成功率较既有注入攻击基线提升 8 倍以上,且攻击效力随辩论轮数增加而增强;它还可以与通信攻击组合——伪造的女巫消息恰好填补被拦截的通信,进一步放大破坏 (Cui & Du, arXiv)。一个本意是提升可靠性的架构,反而创造了单点注入即可带偏全局的攻击面。
四、为什么会这样:三个深层根源
根源一:对齐训练植入的讨好基因。 LLM 的谄媚不是偶然故障,而是 RLHF/指令微调的副产品——人类标注者倾向于奖励”令人满意”的回答,模型于是学会了把”让对方满意”作为可泛化的策略 (Sharma et al., arXiv)。在人机对话中它表现为附和用户;在多智能体辩论中,它表现为附和同伴。Wynn 等人明确把观察到的有害翻转归因于 RLHF 诱导的谄媚行为:模型既没有激励也没有能力去抵抗有说服力但错误的推理 (Wynn et al., arXiv)。辩论设计假设参与者是理性的真理追求者,而对齐训练批量生产的恰恰是礼貌的赞同者。
根源二:同源训练造就的相关错误。 预训练语料的高度重叠、架构与对齐流程的趋同,使模型们共享同一套认知偏差。Estornell 与 Liu 的理论结果表明,当多数意见来自共享训练数据烙入的共同误解时,辩论会结构性地收敛到该误解 (Estornell & Liu, NeurIPS 2024);而 Goel 等人的 CAPA 度量进一步显示,这个问题会随模型变强而恶化而非缓解——前沿模型的错误越来越相似,靠”换更强的模型”来修复辩论的思路在方向上就是错的 (Goel et al., arXiv)。
根源三:辩论优化的是说服力,不是真。 这是最哲学也最致命的一层。辩论是一个博弈:参与者的奖励来自”赢得裁决”而非”接近真理”。除非裁判完美校准,否则修辞优势会持续压倒事实优势——Agarwal 与 Khanna 的实验证明情绪化的谎言能以高置信度击败冷静的真相 (Agarwal & Khanna, arXiv),而”辩论双方都以为自己会赢”的过度自信现象说明辩论过程本身不产生校准 (Prasad & Nguyen, arXiv)。Khan 等人的正面结果之所以成立,恰恰因为他们把辩论限制在一个特殊结构里:存在信息不对称、有独立裁判、辩手立场被外生指定。一旦把同样的机制放进”对等协商”的语境,优化目标的错位就暴露了。
五、辩论并非不可行:边界条件与正确的打开方式
5.1 区分两种辩论:裁判式与协商式
把所有证据摆在一起,一幅清晰的图景浮现出来:辩论能可靠地帮助裁判发现真相,但不能保证辩手自己收敛到真相。Khan 等人 48%→76%、60%→88% 的提升发生在”辩手对抗、独立裁判裁决”的结构中 (ICML 2024 Awards);Kenton 等人发现辩论优于单边咨询,也是在弱裁判监督强辩手的框架下 (Kenton et al., arXiv)。而几乎所有惨烈的失败案例——多数暴政、共识崩溃、对→错翻转——都发生在对等智能体自由协商、多数投票定案的设置里。两者的差别在于:裁判式辩论中,分歧被呈现给裁决者;协商式辩论中,分歧被消灭于从众压力。对实践者的第一条启示就是:如果你要用辩论,让模型把分歧演给你(或一个独立裁判)看,而不是让模型们自己把分歧抹平。
第二条启示来自任务类型与决策协议的匹配。ACL 2025 对七种决策协议的受控比较发现:推理任务适合投票协议(性能提升 13.2%),知识任务适合共识协议(提升 2.8%),投票前增加讨论轮数反而降低表现;而他们为提升答案多样性设计的两个新方法(全体起草 AAD 与集体改进 CI)分别带来最高 3.3% 与 7.4% 的提升 (Kaesberg et al., ACL 2025)。协议选择不是细节,是生死线。
5.2 有证据支持的改进手段
| 改进手段 | 针对的失败模式 | 证据与效果 |
|---|---|---|
| 异构模型组合(不同厂商/架构/训练数据) | 相关错误、回音室 | ReConcile 的消融显示多模型组合比同模型三实例准确率高约 6.8 个百分点,响应多样性显著更高 (ReConcile, arXiv);MAD-Spear 的安全实验也观察到智能体多样性显著提升数学推理表现 (arXiv);Estornell & Liu 理论上证明能力多样性改善辩论 (NeurIPS 2024) |
| 匿名化(隐藏回答来源身份) | 身份偏见、谄媚 | 一致性—固执率差值 Δ 从 0.608 降至 0.024,降幅超 95%,且在多个模型与任务上复现 (Choi et al., arXiv) |
| 置信度加权聚合 | 多数暴政 | ReConcile 圆桌会议+置信度加权投票,较此前单智能体与多智能体基线提升最高 11.4% (ReConcile, arXiv) |
| 投票优先、轮次克制 | 问题漂移、成本爆炸 | 增加智能体数改善表现,增加讨论轮数降低表现 (Kaesberg et al., ACL 2025) |
| 多样性干预/经验记忆 | 静态收敛、共同误解 | Estornell & Liu 提出的干预手段在实验中改善了辩论表现 (NeurIPS 2024);R2-MAD 用历史经验记忆校准概念先验并按智能体可靠性加权,在多个基准上优于已有 MAD 基线 (arXiv) |
| 少数派哨兵(行为信号仲裁器) | 正确的少数派被处决 | 识别”何时推翻多数决”的精度达 81.2%,且净收益在 6 个数据集上全部为正(注意:其 LLM 裁判基线净收益为负,说明”再派一个 LLM 当裁判”并不是稳妥替代方案) (Minority Sentinel, arXiv) |
| 分组辩论+摘要共享 | token 成本 | GroupDebate 降低 token 成本最高 51.7%,部分基准上准确率不降反升(最高提升 25%) (arXiv) |
| 地面真值锚点(外部验证信号) | 说服力压倒真相 | 裁判式辩论的监督收益建立在信息不对称与独立裁决结构上;脱离该结构的开放辩论只测量修辞 (Khan et al., arXiv) |
需要诚实地指出,这些干预大多只被单一团队在有限基准上验证过,没有一个是万能药。但它们共享同一个设计哲学,可以浓缩成一句话:保护独立性,呈现而非消灭分歧,在修正发生前注入信息。反过来,所有失败的配置共享同一个特征:让同质的、被对齐训练调教得过度合群的智能体,在无外部锚点的情况下自由讨论,然后用多数投票把剩余分歧压平。
5.3 一份务实的决策清单
在你决定使用多智能体辩论之前,值得依次回答以下问题。第一,任务有可验证的答案吗?如果有标准答案或外部工具可以验证,辩论(乃至任何多智能体方案)的必要性都大幅下降——直接的自洽性采样或工具验证更便宜也更可靠。第二,单体模型在这个任务上的准确率是否明显高于随机?如果单体能力已逼近随机水平,孔多塞定理反转,多智能体只会更确定地错 (Stanford Encyclopedia of Philosophy)。第三,你的智能体真的独立吗?同一模型的多个实例不是独立意见;即使跨厂商,前沿模型的错误也在趋同 (Goel et al., arXiv)。
第四,你需要的是收敛还是分歧?如果你的目的是发现盲点、暴露不确定性,那么把辩论设置为”对抗呈现+独立裁决”,保留分歧记录而非多数压平;如果目的是产生单一答案,投票通常优于共识,轮次宜少不宜多 (Kaesberg et al., ACL 2025)。第五,成本是否值得?动辄百倍于单体的 token 开销换来的可能只是与自洽性采样相当的收益 (Smit et al., arXiv)。第六,系统是否暴露于不可信输入?如果智能体会读到外部内容,提示注入可以利用从众机制单点攻破整个共识 (Cui & Du, arXiv)。这六问中任何一个答不上来,天真的辩论方案都应该被否决——这大概才是那篇自媒体文章想表达但没说清的内容。
六、结论:那篇文章对了一半
回到最初的争论。自媒体文章描述的机制——掌握错误信息的多数模型带偏掌握正确信息的少数派——是真实、已被形式化证明并被反复实验复现的:它有正式的名字叫多数暴政,有理论证明其结构性必然 (Estornell & Liu, NeurIPS 2024),有实验显示它能让强模型占多数的团队照样崩盘 (Wynn et al., arXiv),甚至能让互不交谈的孤立自我纠错跑赢十智能体的热烈讨论 (Bertalanič et al., arXiv)。在这个意义上,那篇文章的批评切中要害,而且比它自己意识到的更有学术纵深。
但”不可行”是过度概括。同一批文献同样表明:在裁判式结构下,辩论是目前可扩展监督方向最强的实证结果之一 (ICML 2024 Awards);异构组合、匿名化、置信度加权、轮次克制、少数派保护等干预手段各自有实验支持;辩论的收益幻觉问题(是否只是变相集成)则是评估方法学问题,而非范式死刑 (Smit et al., arXiv)。准确的表述应该是:无设计的天真辩论——同质模型、对等协商、多数压平——确实不可行,而且数学上注定了为什么不可行;而经过结构设计的辩论——独立呈现分歧、外部锚定真相、保护少数派声音——仍然是有价值的工具。多数决承诺的群体智慧,从来都要求两个前提:个体比随机强,错误彼此独立。LLM 系统性地违反这两条,所以辩论的失败不是工程不成熟,而是我们把一个有着严格前提的定理,当成了一句”人多力量大”的俗语来使用。认识到这一点,比争论”可不可行”重要得多。
参考文献
奠基性工作:辩论范式的提出与验证
- Irving, G., Christiano, P., & Amodei, D. (2018). AI Safety via Debate. arXiv:1805.00899. https://arxiv.org/abs/1805.00899
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving Factuality and Reasoning in Language Models through Multiagent Debate. ICML 2024. https://arxiv.org/abs/2305.14325
- Liang, T., He, Z., Jiao, W., et al. (2023). Encouraging Divergent Thinking in Large Language Models through Multi-Agent Debate. EMNLP 2024. https://arxiv.org/abs/2305.19118
- Khan, A., Hughes, J., Valentine, D., et al. (2024). Debating with More Persuasive LLMs Leads to More Truthful Answers. ICML 2024(杰出论文奖,ICML 2024 Awards). https://arxiv.org/abs/2402.06782
- Kenton, Z., Janzer, L., Greig, R., et al. (2024). On Scalable Oversight with Weak LLMs Judging Strong LLMs. arXiv:2407.04622. https://arxiv.org/abs/2407.04622
理论地基:陪审团定理、形式化证明与收益分解
- Stanford Encyclopedia of Philosophy. Jury Theorems(孔多塞陪审团定理). https://plato.stanford.edu/archives/win2021/entries/jury-theorems/
- Estornell, A., & Liu, Y. (2024). Multi-LLM Debate: Framework, Principals, and Interventions. NeurIPS 2024. https://proceedings.neurips.cc/paper_files/paper/2024/hash/32e07a110c6c6acf1afbf2bf82b614ad-Abstract-Conference.html
- Smit, A., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). Should We Be Going MAD? A Look at Multi-Agent Debate Strategies for LLMs. ICML 2024. https://arxiv.org/abs/2311.17371
- Choi, H. K., Zhu, J., & Li, Y. (2025). Debate or Vote: Which Yields Better Decisions in Multi-Agent Large Language Models? NeurIPS 2025 (Spotlight). https://arxiv.org/abs/2508.17536
- Wu, H., Li, Z., & Li, L. (2025). Can LLM Agents Really Debate? A Controlled Study of Multi-Agent Debate in Logical Reasoning. arXiv:2511.07784. https://arxiv.org/abs/2511.07784
- Goel, S., Struber, J., Auzina, I. A., et al. (2025). Great Models Think Alike and this Undermines AI Oversight. ICML 2025. https://arxiv.org/abs/2502.04313
失败模式实证:从众、谄媚与共识崩溃
- Asch, S. E. (1956). Studies of Independence and Conformity: I. A Minority of One against a Unanimous Majority. Psychological Monographs: General and Applied, 70(9), 1–70.
- Huang, J., Chen, X., Mishra, S., et al. (2024). Large Language Models Cannot Self-Correct Reasoning Yet. ICLR 2024. https://arxiv.org/abs/2310.01798
- Sharma, M., Tong, M., Korbak, T., et al. (2024). Towards Understanding Sycophancy in Language Models. ICLR 2024. https://arxiv.org/abs/2310.13548
- Pitre, P., Ramakrishnan, N., & Wang, X. (2025). CONSENSAGENT: Towards Efficient and Effective Consensus in Multi-Agent LLM Interactions Through Sycophancy Mitigation. Findings of ACL 2025, 22112–22133. https://aclanthology.org/2025.findings-acl.1141/
- Yao, B., Shang, C., Du, W., et al. (2025). Peacemaker or Troublemaker: How Sycophancy Shapes Multi-Agent Debate. arXiv:2509.23055. https://arxiv.org/abs/2509.23055
- Wynn, A., Satija, H., & Hadfield, G. (2025). Talk Isn’t Always Cheap: Understanding Failure Modes in Multi-Agent Debate. arXiv:2509.05396(ICML 2025 MAS Workshop). https://arxiv.org/abs/2509.05396
- Kaesberg, L. B., Becker, J., Wahle, J. P., Ruas, T., & Gipp, B. (2025). Voting or Consensus? Decision-Making in Multi-Agent Debate. Findings of ACL 2025, 11640–11671. https://aclanthology.org/2025.findings-acl.606/
- Bertalanič, B., et al. (2026). The Cost of Consensus: Isolated Self-Correction Prevails Over Unguided Homogeneous Multi-Agent Debate. arXiv:2605.00914. https://arxiv.org/abs/2605.00914
- Hao, X., Wu, Z., Qiu, Y.-X., et al. (2026). Not All Flips Are Conformity: Decomposing Stance Convergence in Multi-Agent LLM Debate. arXiv:2606.00820. https://arxiv.org/abs/2606.00820
- Guo, et al. (2026). It’s Not Always Sycophancy: Measuring LLM Conformity as a Function of Epistemic Uncertainty (MUSE). arXiv:2605.27288. https://arxiv.org/abs/2605.27288
- Soffer, L., Shwartz-Ziv, R., & Shani, C. (2026). LLMs Trust Their Own: Identity-Dependent Conformity in Multi-Agent Systems. arXiv:2609.33495. https://arxiv.org/abs/2609.33495
- Yerabudala Surendra, Y., et al. (2026). Everyone Conforms, No One Believes: Pluralistic Ignorance in LLM Agent Populations. arXiv:2608.02758. https://arxiv.org/abs/2608.02758
- Hu, Y. (2026). One Axis, No Brake: Self-Knowledge Limits the Filtering of Harmful Peer Conformity in LLMs. arXiv:2609.18998. https://arxiv.org/abs/2609.18998
说服力、裁判偏差与自信动力学
- Agarwal, M., & Khanna, D. (2025). When Persuasion Overrides Truth in Multi-Agent LLM Debates: Introducing a Confidence-Weighted Persuasion Override Rate (CW-POR). arXiv:2504.00374. https://arxiv.org/abs/2504.00374
- Prasad, P., & Nguyen, M. (2025). When Two LLMs Debate, Both Think They’ll Win. arXiv:2505.19184. https://arxiv.org/abs/2505.19184
- Zheng, L., Chiang, W.-L., Sheng, Y., et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS 2023 Datasets and Benchmarks. https://arxiv.org/abs/2306.17685
- Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM Evaluators Recognize and Favor Their Own Generations. NeurIPS 2024. https://arxiv.org/abs/2404.13074
工程化改进、成本与安全
- Chen, J., Saha, S., & Bansal, M. (2024). ReConcile: Round-Table Conference Improves Reasoning via Consensus among Diverse LLMs. ACL 2024. https://arxiv.org/abs/2309.13007
- Liu, T., Wang, X., Huang, W., et al. (2024). GroupDebate: Enhancing the Efficiency of Multi-Agent Debate Using Group Discussion. arXiv:2409.14051. https://arxiv.org/abs/2409.14051
- Choi, H. K., Zhu, X., & Li, Y. (2026). When Identity Skews Debate: Anonymization for Bias-Reduced Multi-Agent Reasoning. ACL 2026. https://arxiv.org/abs/2510.07517
- He, C., Chen, Z., Yang, Z., et al. (2026). Minority Sentinel: When to Overturn Majority Voting in Multi-Agent LLM Debates. SIGIR 2026 AgentSearch Workshop. https://arxiv.org/abs/2606.29270
- Jin, X., Ma, Z., Zeng, Y., et al. (2026). Remember and Reweight: Enhancing Multi-Agent Debate with Experience Memory and Confidence Estimation (R2-MAD). arXiv:2609.03619. https://arxiv.org/abs/2609.03619
- Becker, J., Kaesberg, L. B., Stephan, A., Wahle, J. P., Ruas, T., & Gipp, B. (2026). Stay Focused: Problem Drift in Multi-Agent Debate. Findings of EACL 2026, 5068–5102. https://aclanthology.org/2026.findings-eacl.268/
- Cui, Y., & Du, H. (2025). MAD-Spear: A Conformity-Driven Prompt Injection Attack on Multi-Agent Debate Systems. arXiv:2507.13038. https://arxiv.org/abs/2507.13038